
Das Wichtigste in Kürze
- Amazon hat DuckLabs, das Unternehmen hinter DuckDB, übernommen. Der Prozess wurde am 31. August 2026 abgeschlossen. Seit dem 1. September 2026 ist DuckLabs Teil von Amazon Web Services (AWS).
- DuckDB steht exemplarisch für eine Entwicklung, bei der Datenhaltung und ausführende Compute Engine stärker voneinander getrennt werden können.
- Offene Datenformate erweitern die Möglichkeit, unterschiedliche Engines passend zum jeweiligen Workload einzusetzen. In-Process Engines wie DuckDB zeigen, dass dafür nicht in jedem Fall eine eigene verteilte Compute-Infrastruktur notwendig ist.
- Microsoft Fabric macht dieses Prinzip praktisch sichtbar. OneLake stellt eine gemeinsame Datengrundlage bereit, während unterschiedliche Engines je nach Workload darauf zugreifen können.
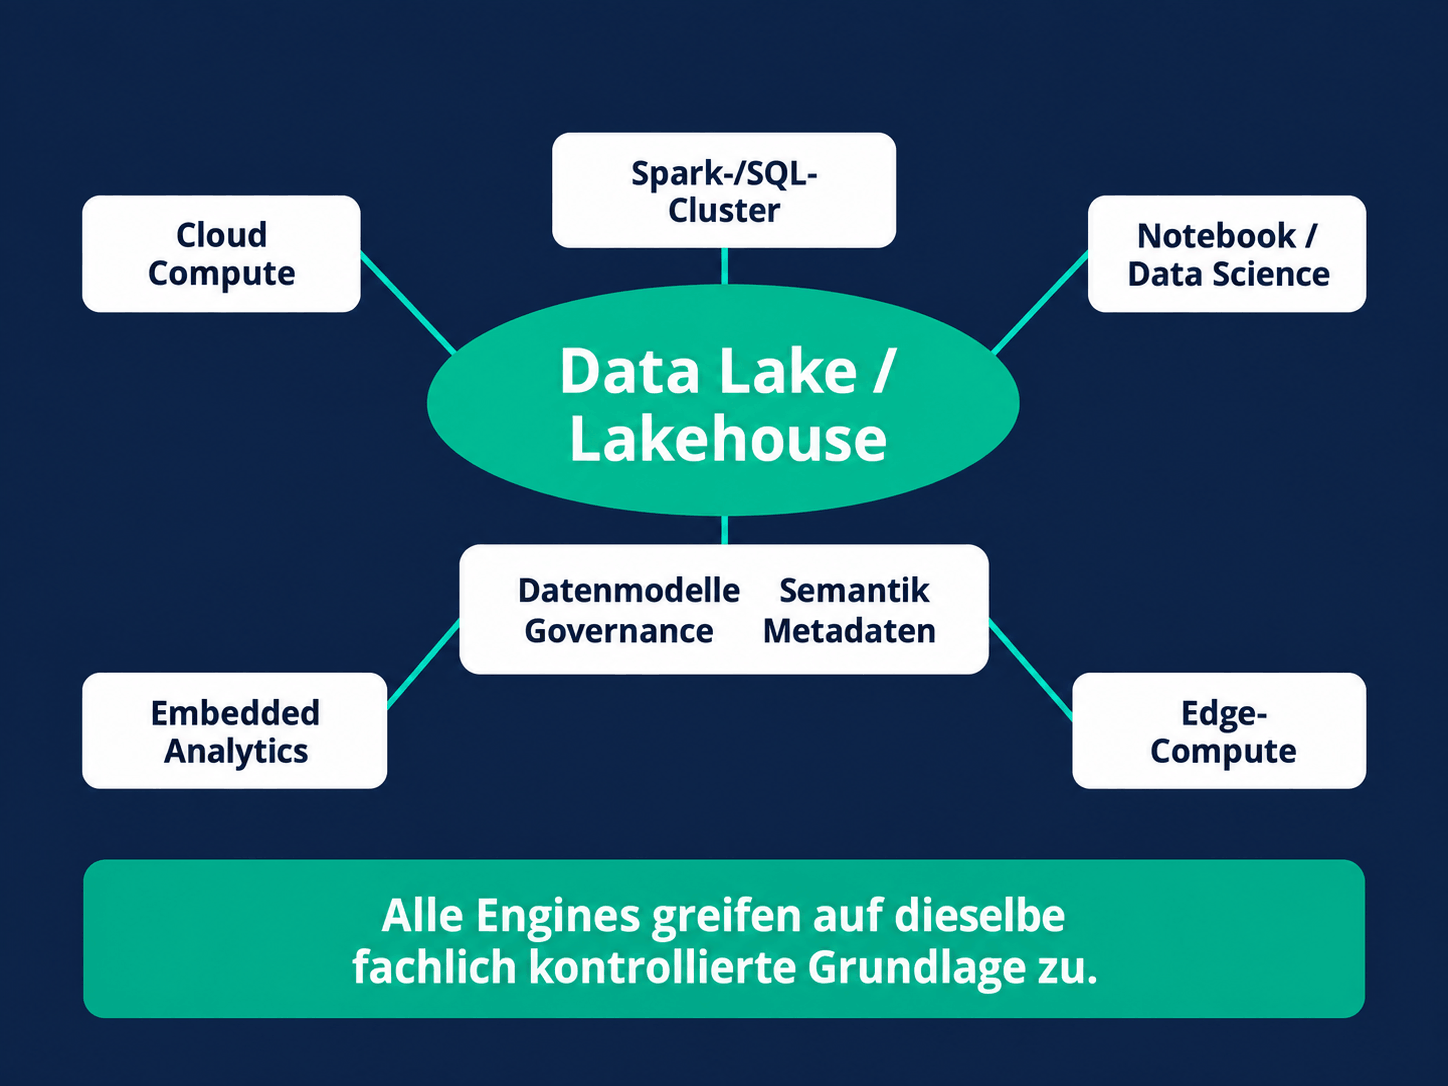
- Je flexibler Compute eingesetzt wird, desto wichtiger werden Datenmodelle, Semantik, Governance, Metadaten und klar geregelte Verantwortlichkeiten.
- Die Datenplattform verliert dadurch nicht an Bedeutung. Ihre Rolle verschiebt sich vom selbstverständlichen Ausführungsort jedes Workloads hin zu einer verbindlichen Grundlage für ein Datenökosystem.
AWS übernimmt DuckLabs. Warum ist das für Datenarchitekten interessant?
Amazon hatte die Übernahme von DuckLabs am 26. August 2026 angekündigt. Der Prozess wurde am 31. August abgeschlossen, seit dem 1. September ist das Amsterdamer Unternehmen hinter DuckDB Teil von AWS. DuckDB, DuckLake, Quack und weitere Open-Source-Komponenten bleiben unter MIT-Lizenz verfügbar. Die unabhängige DuckDB Foundation behält ihre Rolle bei der Stewardship der Projekte.
Welche Services AWS und DuckLabs gemeinsam entwickeln werden, ist derzeit offen. Für die Architekturbetrachtung lohnt sich deshalb zunächst ein Blick auf das technische Prinzip hinter DuckDB.
DuckDB ist eine analytische In-Process-Datenbank. Die Engine kann direkt innerhalb einer Anwendung oder eines Prozesses ausgeführt werden. Ein separater Datenbankserver ist nicht erforderlich. Gleichzeitig kann DuckDB Daten aus offenen Formaten und externem Storage verarbeiten.
Offene Datenhaltung erweitert die Wahl beim Compute
Die technische Trennung von Storage und Compute gehört inzwischen zum Grundprinzip vieler moderner Datenplattformen. Häufig bleiben beide Komponenten trotzdem eng an dasselbe technologische Ökosystem gebunden. Speicherung und Rechenleistung sind getrennt, die Plattform bestimmt aber weiterhin maßgeblich, welche Engines auf den Daten arbeiten.
Offene Datenarchitekturen können diese Kopplung weiter auflösen. Daten in Formaten wie Parquet und offenen Table Formats wie Delta Lake oder Apache Iceberg lassen sich von unterschiedlichen Engines verarbeiten. Wie weit die Interoperabilität reicht, hängt vom jeweiligen Format, den genutzten Funktionen und den Fähigkeiten der Engine ab.
Damit entsteht eine zusätzliche Ebene der Entkopplung: Nicht nur Storage und Compute werden getrennt. Auch die Wahl der ausführenden Engine kann stärker vom Workload abhängen.
Ein großer Transformationsprozess mit hoher Parallelität stellt andere Anforderungen als eine kurze Analyse auf einer begrenzten Datenmenge. Embedded Analytics innerhalb einer Anwendung unterscheidet sich wiederum von einem zentral ausgeführten Monatsabschluss. DuckDB ist deshalb nicht für jeden Workload die richtige Wahl. Genau darin liegt der entscheidende Punkt: Es muss nicht für jeden Workload dieselbe Engine sein.
Microsoft Fabric zeigt, warum diese Wahl praktisch relevant wird
Microsoft Fabric bietet dafür ein konkretes Beispiel. OneLake stellt eine gemeinsame Datengrundlage bereit. Tabellarische Daten werden in offenen Formaten gespeichert und können von mehreren analytischen Engines genutzt werden, ohne sie für jeden Engine-Wechsel neu zu kopieren.
Notebooks lassen sich in Microsoft Fabric entweder auf Basis eines Spark-Runtimes oder in einer eigenständigen Python-Notebook-Umgebung ausführen. In der Python-Umgebung kann DuckDB als In-Process-Engine genutzt werden; auch Bibliotheken wie Polars stehen für die Verarbeitung zur Verfügung. Welche Variante geeignet ist, hängt unter anderem von Datenmenge, Skalierungsbedarf, benötigten Delta-Lake-Funktionen sowie Anforderungen an Monitoring und Support ab.
Für kleine Workloads können In-Process-Engines Vorteile bei Startzeit und Ausführung haben. Mit zunehmender Datenmenge und dem Bedarf an verteilter Verarbeitung spielt Spark seine Stärken aus. Die Entscheidung sollte deshalb nicht aus einer grundsätzlichen Präferenz für eine Engine entstehen, sondern aus den Anforderungen des Workloads.
Damit wird die zusätzliche Architekturfrage konkret: Nicht nur welche Plattform eingesetzt wird, sondern auch welche Engine einen bestimmten Workload sinnvoll ausführt.
Die gemeinsame Datengrundlage wird wichtiger, nicht unwichtiger
Mehr Wahlmöglichkeiten beim Compute bedeuten nicht, dass Unternehmen ihre Datenarchitektur unkontrolliert dezentralisieren sollten. Ein technischer Prozess kennt nicht automatisch die unternehmensweit gültige Umsatzdefinition. Er kennt keine verbindlichen Kundenhierarchien, Zugriffsregeln oder die fachliche Bedeutung einer Kennzahl.
Je mehr Engines und Anwendungen auf dieselben Daten zugreifen, desto wichtiger werden deshalb verbindliche Grundlagen.
Datenmodelle und Datenprodukte
Es muss nachvollziehbar sein, welche Daten für welchen Zweck bereitgestellt werden, wie sie strukturiert sind und wer sie verantwortet.
Business-Logik und Semantik
Kennzahlen, Beziehungen, Hierarchien und fachliche Definitionen sollten nicht in jeder Anwendung oder Engine neu entstehen. Ein verbindlicher Semantic Layer oder vergleichbare semantische Regeln schaffen die gemeinsame Grundlage.
Governance
Berechtigungen, Datenschutz, Klassifizierung und Nutzungsregeln müssen unabhängig davon funktionieren, wo eine konkrete Berechnung ausgeführt wird.
Metadaten und Lineage
Wenn mehrere Engines auf dieselben Daten zugreifen können, muss nachvollziehbar bleiben, welche Daten vorhanden sind, woher sie stammen und wie sie verwendet werden.
Die technische Ausführung kann damit flexibler werden. Die fachliche Grundlage sollte verbindlich bleiben.
Verteilter Compute verändert auch die Verantwortung
Die technische Möglichkeit, einen Workload außerhalb der zentralen Plattform auszuführen, löst die betrieblichen Fragen nicht. Wenn unterschiedliche Engines innerhalb von Anwendungen, Notebooks, Pipelines oder anderen Laufzeitumgebungen eingesetzt werden, müssen Versionierung, Berechtigungen, Monitoring, Security und Ownership geklärt sein.
Auch die Transformations- und Business-Logik braucht einen definierten Ort. Sonst entstehen zwar nicht zwingend neue Datenkopien, aber unterschiedliche Versionen derselben fachlichen Logik. Damit würde sich das Problem lediglich von der Datenhaltung auf die Verarbeitung verlagern.
Compute-Flexibilität braucht deshalb einen technischen und organisatorischen Rahmen. Dazu gehört auch die bewusste Entscheidung, welche Verarbeitung zentral bleiben sollte und wo eine dezentrale Ausführung tatsächlich Vorteile bringt.
Von der Datenplattform zum Datenökosystem
Das klassische Data Warehouse konzentrierte analytische Datenhaltung und Verarbeitung stark an einem zentralen Ort. Moderne Datenplattformen haben diesen Auftrag bereits erweitert. Sie stellen Daten für BI, Data Science, Machine Learning, Datenprodukte und weitere Anwendungen bereit.
Flexiblerer Compute führt diese Entwicklung weiter. Ein Teil der Verarbeitung kann innerhalb der zentralen Plattform stattfinden. Ein anderer Teil kann näher an einer Anwendung, einem Data-Science-Prozess oder einem operativen System ausgeführt werden.
Die Datenplattform bleibt dabei ein wichtiger Bestandteil der Architektur. Sie muss aber nicht mehr automatisch der Ausführungsort für jede Berechnung sein. Ihre Rolle verschiebt sich stärker in Richtung einer verlässlichen Grundlage für das gesamte Datenökosystem.
Dazu gehören Daten, fachliche Modelle, Governance, Zugriffssteuerung und Metadaten. Je mehr Verarbeitung außerhalb der zentralen Plattform stattfindet, desto wichtiger wird diese gemeinsame Grundlage.
Fünf Fragen für die Architekturentscheidung

Für die konkrete Zielarchitektur sind fünf Fragen hilfreicher als die pauschale Entscheidung für eine bestimmte Plattform oder Engine.
1. Wie sieht der Workload aus?
Wie groß sind die Datenmengen? Wie komplex sind die Abfragen? Wie häufig werden sie ausgeführt? Wie viele Nutzer oder Prozesse greifen gleichzeitig darauf zu?
2. Wo dürfen die Daten verarbeitet werden?
Datenschutz, Datenklassifizierung und regulatorische Anforderungen können den möglichen Ausführungsort einschränken. Nicht jeder Workload darf an jedem Ort ausgeführt werden.
3. Welche Latenz ist erforderlich?
Ein Monatsreport hat andere Anforderungen als Analytics innerhalb einer operativen Anwendung. Je enger die Verarbeitung mit einem operativen Prozess verbunden ist, desto relevanter kann die technische Nähe zwischen Daten, Anwendung und Compute werden.
4. Wie hoch sind die Gesamtkosten?
Nicht nur die reine Compute-Leistung zählt. Datentransfer, Storage, Laufzeit, Betrieb, Monitoring und personeller Aufwand gehören zur Bewertung.
5. Wer verantwortet den Workload?
Bei zentralen Plattformen sind Betrieb und Verantwortung meist klar zugeordnet. Bei Embedded Analytics oder anderen verteilten Ausführungsformen können Aufgaben stärker in Produkt- oder Anwendungsteams wandern. Diese Verantwortung sollte vor der technischen Umsetzung geklärt sein.
Was lässt sich aus der AWS-Übernahme ableiten?
Welche konkreten Produkte oder Services aus der Übernahme von DuckLabs entstehen, lässt sich derzeit nicht seriös vorhersagen. DuckLabs und AWS haben angekündigt, die Technologien künftig für neue Data Services weiterzuentwickeln. Konkrete Produktarchitekturen wurden bislang nicht vorgestellt.
Als Signal für die Entwicklung moderner Datenarchitekturen ist die Übernahme dennoch relevant. AWS integriert ein Unternehmen, dessen zentrale Technologie analytischen Compute nicht an einen klassischen zentralen Datenbankserver bindet.
Diese Architekturidee reicht über DuckDB hinaus. Offene Datenformate, Open-Lakehouse-Architekturen und eine wachsende Auswahl an Compute Engines erweitern den Gestaltungsspielraum für Datenhaltung und Verarbeitung.
Fazit
Die interessante Konsequenz der DuckLabs-Übernahme liegt nicht darin, dass DuckDB bestehende Datenplattformen ersetzt. Relevant ist die zunehmende Möglichkeit, Datenhaltung und ausführenden Compute unabhängiger voneinander zu gestalten.
Für Unternehmen entsteht dadurch mehr technischer Spielraum. Gleichzeitig steigen die Anforderungen an die gemeinsame Datengrundlage. Datenmodelle, Semantik, Governance, Metadaten und Verantwortlichkeiten werden nicht weniger wichtig, wenn Compute verteilt wird. Sie werden zur Voraussetzung dafür, dass diese Flexibilität kontrolliert genutzt werden kann.
Die zentrale Architekturfrage lautet deshalb zunehmend: Welche Aufgaben soll die Datenplattform verbindlich übernehmen und welcher Workload sollte mit welcher Engine an welchem Ort ausgeführt werden?
