
Das Wichtigste in Kürze
- Bei der Git-basierten Methode wird das Repository zur verbindlichen Quelle für den Entwicklungsstand. Änderungen entstehen weiterhin im Workspace, werden aber erst mit dem Commit Teil des versionierten Stands.
- Ein Workspace ist mit genau einem Branch und einem Ordner verbunden. Die Stage-Trennung entsteht dadurch, dass jede Umgebung ihren eigenen Branch und ihren eigenen Workspace bekommt.
- Die Promotion läuft über Pull Requests. Über Branch Policies lassen sich verpflichtende Reviews einrichten. Nach dem Merge übernimmt der Ziel-Workspace den neuen Stand über ein Update.
- Der Zugewinn gegenüber Deployment Pipelines liegt in Historie, Rollback und strukturierten Code-Reviews, auch für DAX und Power-Query-Logik.
- Strukturell verschiebt sich Verantwortung Richtung Engineering. Wer die Git-Arbeitsweise nicht mitgeht, fällt aus dem Prozess heraus.
Wenn der Workspace nicht mehr die Quelle der Wahrheit ist
Deployment Pipelines reichen Stände von Workspace zu Workspace weiter. Der jeweils aktuelle Stand lebt dabei in Fabric selbst. Die Git-basierte Methode dreht dieses Verhältnis um. In diesem Betriebsmodell wird das Repository zur verbindlichen Quelle. Änderungen entstehen weiterhin im Workspace, werden aber erst mit dem Commit Teil des versionierten Entwicklungsstands.

Dieser Beitrag ist der dritte Teil unserer Serie zu CI/CD in Microsoft Fabric. Wir messen auch diese Methode an den drei Ebenen aus dem ersten Teil: der Prozess-Ebene mit Lakehouse oder Warehouse, Notebooks, Pipelines und Shortcuts, der Modell-Ebene mit dem Semantic Model und der Reporting-Ebene mit Reports und Apps. Teil zwei hat gezeigt, wie Deployment Pipelines diese Ebenen über Pairing und Deployment Rules verbinden. Bei der Git-basierten Methode werden die Artefaktdefinitionen dagegen über Branches transportiert. Die Anpassung ihrer Referenzen an die Zielumgebung, das eigentliche Neuverdrahten, muss separat gelöst werden.
Wie die Methode funktioniert
Die Git-Integration setzt auf Workspace-Ebene an. Ein Workspace wird mit einem Repository verbunden, und zwar mit genau einem Branch und einem Ordner darin. Als Provider unterstützt Fabric Azure DevOps, GitHub und GitHub Enterprise, jeweils in der Cloud-Variante.
Ab diesem Punkt arbeiten Sie in zwei Richtungen. Änderungen im Workspace übertragen Sie mit einem Commit in den Branch. Änderungen im Branch holen Sie mit einem Update in den Workspace. Die Items liegen im Repository als Dateien, Notebooks als Code, Pipelines und Semantic Models in ihren jeweiligen Definitionsformaten. Damit sind sie diffbar, reviewbar und wiederherstellbar.
Die Stage-Trennung ergibt sich aus der Branch-Struktur. Jede Umgebung bekommt einen eigenen Branch und einen eigenen Workspace, typischerweise nach dem Muster development, test und main. Eine Änderung wandert nicht von Workspace zu Workspace, sondern von Branch zu Branch. Der Ziel-Workspace zieht den neuen Stand anschließend über ein Update nach.
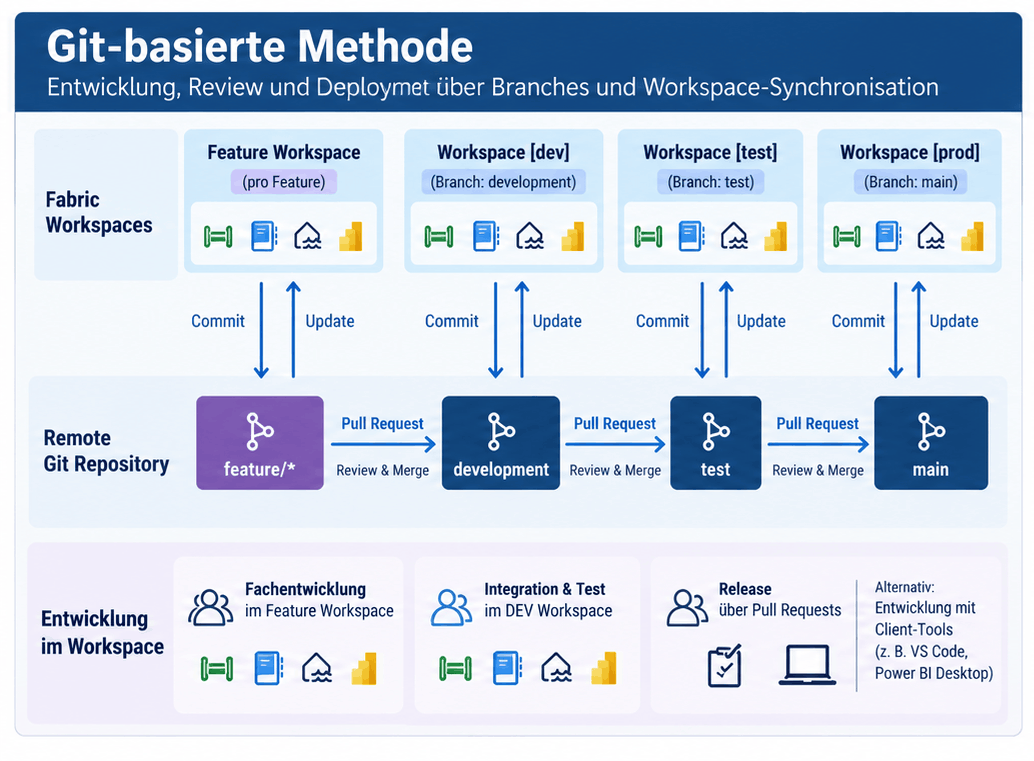
Für die parallele Entwicklung gibt es das Branch-Out. Ein Entwickler erzeugt aus dem aktuellen Stand einen eigenen Branch und einen eigenen Workspace, arbeitet dort isoliert und bringt das Ergebnis über einen Pull Request zurück. Damit lösen Sie das Problem, dass ein Workspace immer eine gemeinsame Laufzeitumgebung ist, in der sich Änderungen sofort gegenseitig beeinflussen. Alternativ arbeiten Entwickler mit Client-Tools wie Power BI Desktop oder VS Code direkt gegen das Repository.
Der Review passiert im Git-Provider, nicht in Fabric. Über Branch Policies lässt sich festlegen, dass Änderungen vor dem Merge von einer zweiten Person geprüft werden müssen. Nach dem Merge ist der Stand im Zielbranch, im Ziel-Workspace aber noch nicht. Diesen letzten Schritt lösen Teams entweder mit einem Klick im Source-Control-Panel oder über die Fabric-APIs aus einer Release-Pipeline heraus.
So wandern die Ebenen mit
Auf der Prozess-Ebene versioniert Git die Definitionen von Notebooks, Pipelines und Lakehouses. Was Git nicht mitbringt, ist ein Mechanismus, der umgebungsabhängige Werte automatisch ersetzt. Verweist ein Notebook auf ein bestimmtes Default Lakehouse oder einen SQL-Endpunkt, steht diese Referenz so in der Datei, wie sie committet wurde.
Eine Möglichkeit sind Variable Libraries, die ebenfalls als Fabric Item versioniert werden. Für jeden Workspace wird das passende Value Set in der Oberfläche aktiviert. Notebooks können die Variablen im Code auslesen, Shortcuts sie beispielsweise für umgebungsabhängige Pfade verwenden. Voraussetzung ist, dass die entsprechenden Referenzen von Anfang an parametrisiert werden. Alternativ lassen sich Anpassungen über zusätzliche Automatisierung in GitHub Actions oder Azure DevOps Pipelines umsetzen.
Auf der Modell- und Reporting-Ebene wird das Neuverdrahten anspruchsvoller. Anders als bei Deployment Pipelines steht kein vergleichbarer automatischer Pairing-Mechanismus zur Verfügung. Insbesondere die Bindung zwischen Semantic Model und Lakehouse sowie zwischen Report und Semantic Model muss beim Wechsel der Umgebung berücksichtigt werden. Ohne zusätzliche Maßnahmen können Referenzen auf Objekte aus DEV bestehen bleiben. Für diese Anpassungen sind häufig ergänzende Skripte oder andere Automatisierungen erforderlich.
Die Tabellendaten im Lakehouse bleiben außen vor. Git versioniert die Definition, nicht den Inhalt. Das Befüllen der Zielumgebung ist ein eigenes DataOps-Thema.
Die Stärken: Historie, Review, Rollback
Der Zugewinn gegenüber der Portal-Methode liegt in der Nachvollziehbarkeit. Jede Änderung hängt an einem Commit mit Autor, Zeitpunkt und Kommentar. Sie sehen, welche Zeile eines DAX-Measures sich geändert hat, und können auf einen früheren Stand zurückgehen, ohne ihn aus einer Sicherung rekonstruieren zu müssen.
Der zweite Punkt ist der Review. Über Branch Policies können Teams sicherstellen, dass Änderungen geprüft werden, bevor sie in die nächste Umgebung gelangen. Für Notebooks ist das vertrautes Terrain. Für Semantic Models und Reports ist es der Schritt, mit dem Power-BI-Entwicklung an denselben Qualitätsmaßstäben gemessen wird wie der Rest der Plattform.
Die Git-Struktur lässt sich später um Tests, Freigaberegeln und automatisierte Deployments erweitern. Teil vier zeigt mit fabric-cicd eine Möglichkeit, diese Automatisierung umzusetzen.
Die Grenzen: Lernkurve und der letzte Schritt
Die Methode setzt voraus, dass das Team Git als Arbeitsmodell akzeptiert. Branches, Merge-Konflikte und Pull Requests gehören dann zum Alltag, auch für Kolleginnen und Kollegen, die bisher ausschließlich im Portal gearbeitet haben. Diese Lernkurve ist der häufigste Grund, warum die Umstellung stockt.
Operativ bleibt der letzte Schritt offen. Der Merge in den Zielbranch bringt den Stand noch nicht in den Ziel-Workspace. Damit können Repository und Workspace auseinanderlaufen: Der Merge ist abgeschlossen, der produktive Workspace arbeitet aber noch mit dem vorherigen Stand. Ohne zusätzliche Automatisierung ist das Update ein manueller Klick. Mit Automatisierung übernimmt eine Release-Pipeline diesen Schritt, die jemand bauen und pflegen muss. Die Methode liefert Versionierung, aber keine fertige Deployment-Automatisierung.
Dazu kommen einige Randbedingungen, die in der Planung gern übersehen werden. Verbindungen und Branch-Wechsel verwaltet der Workspace-Admin, nicht jeder Beitragende. Items, die die Git-Integration nicht unterstützt, werden ignoriert und tauchen im Repository nicht auf, bleiben im Workspace aber bestehen. Für Commits gilt eine Größenbegrenzung von 125 MB.
Die strukturelle Konsequenz
Für die Methodenwahl zählt vor allem die Verschiebung der Verantwortung. Die Git-basierte Methode holt Engineering-Praktiken in ein Feld, das vorher im BI-Team lag. Wer Repository, Branch-Regeln und Freigabelogik definiert, gestaltet damit die Arbeitsweise aller Beteiligten mit.
Sie bekommen Historie, Reviews und parallele Entwicklung. Dafür braucht es einen Prozess, den alle Beteiligten mittragen. Ein Team, in dem zwei Personen Git beherrschen und fünf im Portal weiterarbeiten, hat am Ende beides: den Overhead der neuen Methode und die Unklarheit der alten.
Geeignet ist der Weg für Teams mit Engineering-Affinität, für Organisationen mit mehreren parallel arbeitenden Domänen und überall dort, wo Nachweisbarkeit gefordert ist. Als Teil eines hybriden Ansatzes funktioniert er ebenfalls: Notebooks und Pipelines werden über Git versioniert und bereitgestellt, während reportingnahe Artefakte weiterhin über Deployment Pipelines wandern.
Fazit: Das Fundament, auf dem Automatisierung aufsetzt
Die Git-basierte Methode bringt Versionierung, Historie und Reviews in die Fabric-Entwicklung und macht Entwicklungsstände nachvollziehbar und wiederherstellbar. Der Preis ist eine Lernkurve und ein Prozess, der Disziplin verlangt.
Was sie nicht mitliefert, ist eine vollständige Deployment-Automatisierung. Der Weg vom gemergten Branch in den produktiven Workspace bleibt Handarbeit oder erfordert ergänzendes Tooling. Wie sich dieser Schritt automatisieren lässt und welche Voraussetzungen das an eine Organisation stellt, betrachten wir im vierten Teil der Serie mit dem fabric-cicd Framework.
FAQ

Dieser Beitrag kann Texte und Bilder enthalten, die mithilfe künstlicher Intelligenz erstellt oder bearbeitet wurden. Sämtliche Inhalte unterliegen unserer redaktionellen Kontrolle.

