
Das Wichtigste in Kürze
- Auf der AIDAQ 2026 rückte neben dem hohen Entwicklungstempo von AI vor allem die Frage in den Mittelpunkt, wie Unternehmen vom Experiment zur Skalierung kommen.
- Mit zunehmend austauschbaren Modellen gewinnt der Unternehmenskontext an Bedeutung. Datenmodelle, fachliches Wissen und geeignete Kontrollmechanismen bestimmen wesentlich, wie belastbar AI-Anwendungen arbeiten.
- Unternehmenswissen muss für Agenten zugänglich werden. Metadata Management, Knowledge Graphs und andere Ansätze können helfen, fachliche Zusammenhänge strukturiert bereitzustellen.
- Skalierbare AI-Anwendungen brauchen mehr als leistungsfähige Agenten. Entscheidend ist ihre Einbettung in belastbare Prozesse und bestehende Unternehmensarchitekturen.
- Das hohe Entwicklungstempo erhöht die Bedeutung von Investitionsschutz: Architekturen sollten Modellwechsel ermöglichen und fachliches Wissen langfristig nutzbar halten.
AIDAQ 2026: Vom AI-Pilot zur Skalierung
Exponentielles Wachstum war eines der großen Motive auf der AIDAQ 2026 in Berlin. Anders Indset zeichnete in seiner Opening Keynote eine Zukunft, in der AI immer schneller leistungsfähiger wird und die Grenzkosten für Compute, Energie und Arbeit langfristig stark sinken. Schon beim Pre-Event hatte Philipp Justus die kurzen Releasezyklen der Gemini-Modelle als konkretes Beispiel für das hohe Entwicklungstempo genannt.
Diese Geschwindigkeit ist beeindruckend. Bei den wirtschaftlichen Schlussfolgerungen bin ich vorsichtiger. Ein neues Modell macht einen bestehenden Unternehmensprozess nicht automatisch produktiver. Auch ein niedrigerer Tokenpreis bedeutet nicht zwangsläufig niedrigere Gesamtkosten, wenn gleichzeitig immer mehr Tokens verarbeitet werden.
Auf der AIDAQ fiel mehrfach eine weitere Aussage: Modelle werden zunehmend zur Commodity. Für Unternehmen verschiebt sich damit ein Teil der Arbeit. Sie müssen AI so in ihre Architektur und Prozesse integrieren, dass daraus dauerhaft ein Nutzen entsteht.
Für mich war damit auch das eigentliche Thema der AIDAQ gesetzt: Wie kommen Unternehmen vom Experiment zur Skalierung?
1. AI verbreitet sich anders als klassische Unternehmenssoftware
Beim Pre-Event nannte Philipp Justus eine Zahl, die diesen Übergang gut beschreibt: 88 Prozent der Nutzung der Gemini-Modelle fänden im privaten Umfeld statt, nur 12 Prozent im professionellen Kontext. Die private Adaption läuft demnach deutlich schneller.
Das ist wenig überraschend. Einen Chatbot nach einer Hotelempfehlung zu fragen oder einen privaten Text überarbeiten zu lassen, ist niedrigschwellig. In einem Unternehmen muss dieselbe Technologie mit internen Daten arbeiten, Berechtigungen beachten und in bestehende Systeme eingebunden werden. Fehler können wirtschaftliche oder regulatorische Folgen haben.
Dazu kommt ein struktureller Unterschied zu vielen früheren IT-Transformationen. Ein neues ERP- oder Konsolidierungssystem wird von Beginn an als Unternehmensanwendung gedacht. Generative AI kam dagegen über den Browser auf den Arbeitsplatz. Mitarbeiter probieren unterschiedliche Modelle aus, Fachbereiche entwickeln eigene Anwendungsfälle und erste Prozesse entstehen lokal.
Das erinnert an die Verbreitung von Self-Service BI. Auch dort entstanden zunächst Lösungen in einzelnen Fachbereichen. Power BI oder Tableau wurden mit Excel-Dateien, Access-Datenbanken oder lokalen Extrakten verbunden und lösten konkrete Probleme schnell und pragmatisch. Erst später stellte sich die Frage, wie aus dieser Landschaft ein beherrschbares Gesamtbild wird.
Bei AI sehen wir eine ähnliche Bewegung. Unternehmen müssen eine bereits laufende, dezentrale Nutzung in einen Enterprise-Rahmen überführen. Das ist eine andere Art der Transformation als der zentrale Rollout einer neuen Unternehmenssoftware.
2. Der Engpass verschiebt sich vom Modell zum Kontext
Je stärker AI in Unternehmensprozesse wandert, desto wichtiger wird der Kontext, in dem ein Modell arbeitet.
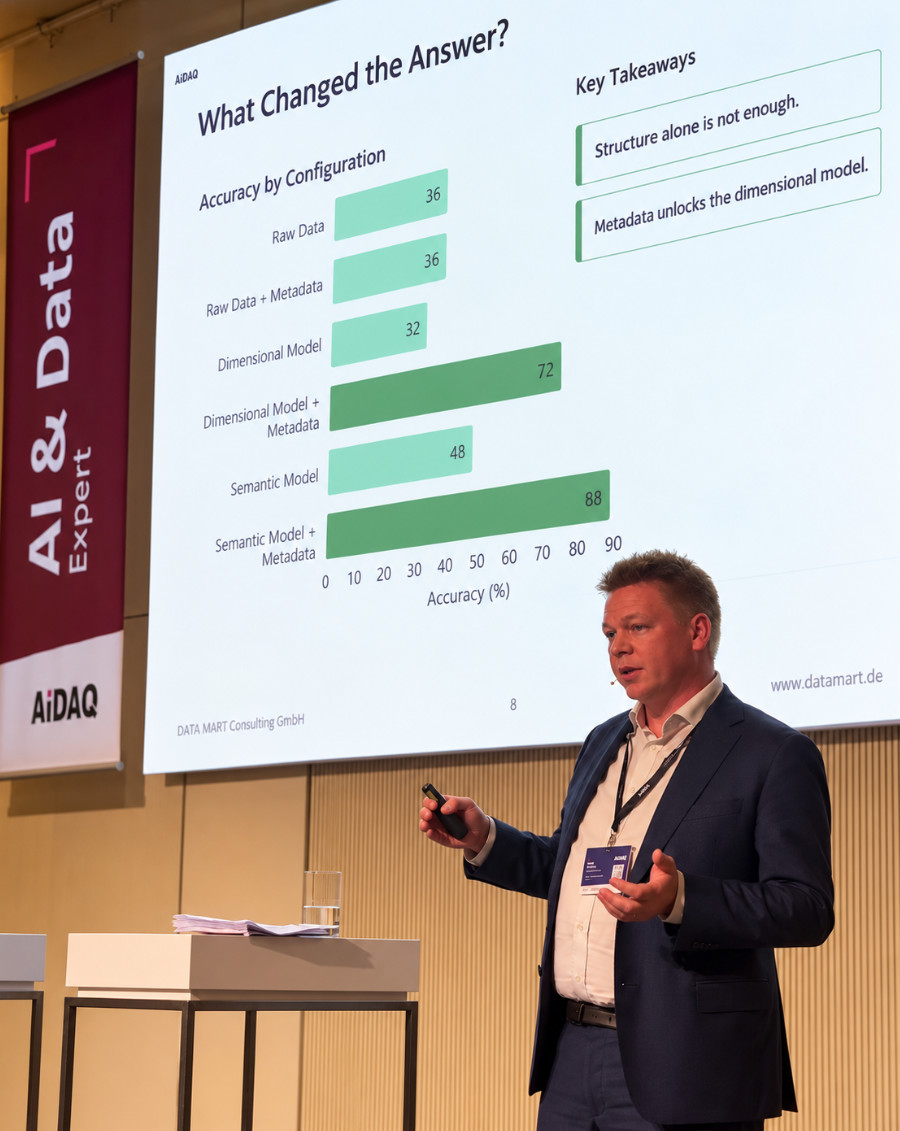
Das war auch der Ausgangspunkt meines eigenen Vortrags auf der AIDAQ. In einem Experiment habe ich sechs Konfigurationen einer AI-gestützten Datenanalyse anhand von 25 identischen Business-Fragen verglichen: von weitgehend unbearbeiteten Rohdaten bis zu einem semantischen Modell mit zusätzlichem Kontext.
Dabei zeigte sich, dass bereits Datenmodellierung eine Form von Kontext ist. Ein Datenmodell strukturiert nicht nur Tabellen. Es enthält Entscheidungen darüber, wie Entitäten zusammengehören und wie Daten fachlich interpretiert werden sollen. Der Agent muss dadurch weniger selbst erschließen.
Das Experiment zeigte aber auch die Grenzen dieser Betrachtung. Struktur allein reicht nicht. Für belastbare Antworten braucht es zusätzlich fachliches Wissen und geeignete Kontrollmechanismen.
Auf der AIDAQ tauchte diese Frage in vielen Formen auf. Knowledge Graphs, Ontologien und Wissensbasen für Agenten waren auffällig präsent. Die Ansätze unterscheiden sich, adressieren aber dasselbe Problem: Ein Sprachmodell kennt die Fachlichkeit eines Unternehmens nicht automatisch.
3. Unternehmenswissen muss für Agenten zugänglich werden
Das Experiment zeigt die Bedeutung von Kontext auf der Ebene eines Datenmodells. Auf der AIDAQ wurde deutlich, wie viel weiter der Begriff im Unternehmen reicht.
Metadata Management kann beispielsweise technische Strukturen mit fachlichen Modellen, Definitionen und Lineage verbinden. Cataloging wird damit Teil der Unternehmensarchitektur und kann Zusammenhänge bereitstellen, die Agenten für ihre Arbeit benötigen.
Ein anderer Teil des Wissens steckt in den Köpfen der Mitarbeiter. Auf der Konferenz wurden Ansätze gezeigt, bei denen Agenten dieses implizite Wissen im Dialog erfassen und mit bestehenden Informationen verbinden. Knowledge Graphs können anschließend helfen, Beziehungen zwischen diesen Informationen maschinenlesbar abzubilden.
Für die Skalierung von AI wird damit auch die Organisation von Unternehmenswissen zur Architekturaufgabe. Es muss auffindbar und strukturiert genug sein, damit Agenten es im richtigen Kontext verwenden können.
4. Aus einem Agenten wird noch kein Unternehmensprozess
Auch mit einer guten Wissensbasis bleibt die Integration in reale Prozesse anspruchsvoll. Multi-Agent-Architekturen waren deshalb ein wiederkehrendes Thema auf der AIDAQ. Komplexe Aufgaben werden in Teilaufgaben zerlegt, die von spezialisierten Agenten oder klassischen Softwarekomponenten bearbeitet werden. Schnittstellen verbinden sie mit bestehenden Systemen.
Ein anschauliches Beispiel ist die automatisierte Verarbeitung von Grundbuchauszügen. Unterschiedliche Formate und teilweise handschriftliche Inhalte machen bereits die Erfassung schwierig. „Wir lassen das von AI auslesen“ beschreibt nur einen kleinen Teil der Aufgabe.
Ein robuster Prozess kann Texterkennung und fachliche Zuordnung getrennt behandeln. Je nach Fehlerpotenzial kommen deterministische Verarbeitung, AI oder zusätzliche Kontrollen zum Einsatz. An kritischen Stellen kann weiterhin ein menschlicher Review nötig sein.
Der Agent ist darin eine Komponente, nicht die Architektur selbst.
5. Skalierung beginnt mit den eigenen Prozessen
Agentische Automatisierung setzt voraus, dass Unternehmen ihre Abläufe ausreichend gut verstehen. Auch das war auf der AIDAQ ein wiederkehrender Punkt: Bevor Prozesse automatisiert werden können, müssen sie häufig erst erfasst und hinterfragt werden.
Gerade historisch gewachsene Abläufe enthalten Ausnahmen und informelle Entscheidungen, die in keiner Prozessbeschreibung stehen. Für eine Automatisierung reicht es nicht, den bestehenden Ablauf technisch nachzubauen. Es kann sinnvoller sein, ihn vorher zu vereinfachen oder anders zu schneiden.
Das verändert auch die Rolle von Daten. In vielen Unternehmen wurden sie lange nachgelagert für Reporting, Controlling oder strategische Entscheidungen aufbereitet. Agentische Systeme greifen direkt in operative Abläufe ein. Daten und das dazugehörige Unternehmenswissen werden damit unmittelbarer Teil operativer Wertschöpfungsprozesse.
6. Geschwindigkeit macht Investitionsschutz wichtiger
Die Zukunftsbilder auf der AIDAQ lagen weit auseinander. Sie reichten von sehr optimistischen Szenarien exponentiellen Fortschritts bis zu Judith Dadas „Europe 2031“, das vor einem technologisch zurückfallenden Europa warnt. Gemeinsam ist ihnen der hohe Handlungsdruck.
Abzuwarten, bis sich die Technologie stabilisiert hat, halte ich deshalb für keine realistische Strategie. Gerade das hohe Entwicklungstempo macht aber Investitionsschutz wichtiger.
Wenn Modelle zunehmend zur Commodity werden, sollte ein Unternehmensprozess nicht um die Modellgeneration dieses Monats herum gebaut werden. Ein Modellwechsel kann bedeuten, Prompts erneut zu prüfen, Evaluationen zu wiederholen und das Verhalten innerhalb längerer Prozessketten neu zu bewerten. Wer jedem Release hinterherläuft, produziert schnell selbst einen erheblichen Teil der Komplexität.
Methodisches und möglichst technologieagnostisches Vorgehen gewinnt dadurch an Wert. Fachliches Wissen und Prozessbeschreibungen sollten einen Modellwechsel überstehen. Schnittstellen sollten ihn ermöglichen, wenn eine neue Generation einen echten Vorteil bringt.
Investitionsschutz ist dabei kein Grund, die Transformation aufzuschieben. Er bedeutet für mich, heute so zu investieren, dass die Arbeit auch nach dem nächsten Technologiesprung noch einen Wert hat.
Vom Experiment zur Unternehmensarchitektur
Für mich bleibt von der AIDAQ vor allem das Thema Skalierung hängen. Die Modelle entwickeln sich schnell. Die schwierigere Arbeit verlagert sich zunehmend in den Enterprise-Kontext.
Dort müssen Modelle auf Daten und Unternehmenswissen zugreifen, in reale Prozesse eingebunden werden und austauschbar bleiben. Mich beschäftigt deshalb inzwischen weniger die Frage nach dem nächsten Modell als das, was Unternehmen um diese Modelle herum aufbauen.
Dort entscheidet sich, ob aus vielen guten AI-Experimenten ein belastbarer Teil der Wertschöpfung wird.


